
扫码与数据项目顾问沟通
我们会围绕项目场景、数据规模与交付节奏提供建议
数据采集 / 数据标注 / 算法支撑 / 项目协同 / 行业交流
行业洞察
大模型与多模态浪潮下:2026年算法研发服务的需求演变多模态大模型与具身智能等技术的突破,彻底重塑了企业引入AI算法的底层逻辑。
进入2026年,算法研发服务趋势正经历从“单点PoC算法定制”向“全闭环数据驱动、多模态大模型对齐与垂直场景Agent落地”的范式重构。随着生成式AI与多模态大模型的深度普及,企业对算法研发服务的需求已从纯模型开发扩展至全生命周期运营——涵盖前期需求评估、高质量数据集准备与专家标注、大模型微调与评测、轻量化部署以及生产环境下的数据闭环搭建。兼顾算法精度、算力ROI、数据合规与长尾场景泛化能力的端到端服务,已成为企业AI战略落地的决定性因素。
多模态大模型与具身智能等技术的突破,彻底重塑了企业引入AI算法的底层逻辑。传统针对单一图像分类、文本抽取的浅层算法开发模式,正在被全感知、高推理能力的大模型演进方案所取代。
在前几年的AI探索期,大量企业停留在概念验证(PoC)阶段,导致许多项目因长尾场景泛化差、推理解算成本过高而难以投产。2026年的企业技术团队在采购算法研发服务时,首要关注指标已从单纯的“实验室准确率”转向“生产环境下的投产比(ROI)、高吞吐低延迟与长尾场景处理能力”。
随着文本、视觉、音频和传感器时序数据的统一建模,算法研发不再是孤立的代码编写,而是高度依赖场景化数据的深加工。工业质检、医疗诊断、智能驾舱与金融风控等领域,要求算法研发服务团队不仅掌握模型架构,还要具备构建高精度数据集和行业专家标注知识图谱的能力。
成熟的算法研发服务必须打通“数据-模型-业务场景”的全链路,确保算法模型落地后具备持续自进化能力。
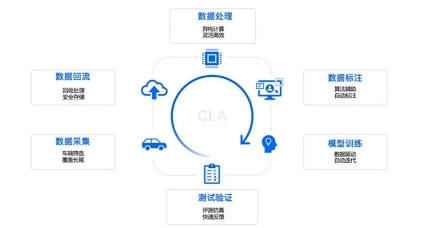
数据驱动的算法研发闭环架构. 来源:42 号车库
项目启动初期,服务团队需与企业技术负责人及业务团队共同进行系统化的需求评估:
业务边界锚定:明确算法需解决的核心场景(如边缘端实时推理或云端高精度分析)。
算力与成本建模:评估全量微调(Full Fine-Tuning)与参数高效微调(LoRA/QLoRA)的资源投入,制定符合成本预算的技术路线。
数据可获得性预判:评估企业现有数据资产储备,规划缺口数据的采集与补充方案。
数据集的质量直接决定了算法模型的上限。通过将AI预标注工具与行业专家标注机制深度绑定,能够实现高效的数据清洗、多模态对齐与属性标定。
根据场景要求,选择基础大模型进行领域增量预训练、指令微调(SFT)或基于人类反馈的直接偏好优化(DPO/RLHF),实现通用能力向垂直业务能力的精准迁移。
在模型交付前,通过搭建多维度评测基准(Benchmark),对模型的准确率、幻觉率、鲁棒性以及端侧推理延迟进行严格测试,并通过蒸馏、量化与剪枝提升线上推理吞吐量。
部署上线并非终点。算法服务团队帮助企业搭建数据闭环系统,将线上拦截到的难例(Bad Cases)自动回流、脱敏并重新触发标注与微调,驱动算法持续演进。
为帮助企业管理者清晰评估不同算法研发服务模式的优劣,下表梳理了技术交付与数据服务的核心差异:
| 评估维度 | 传统算法定制服务 | 2026全栈数据+算法闭环研发服务 | 企业落地价值 |
| 研发焦点 | 单一模型代码编写与参数调优 | 大模型微调 + 多模态对齐 + 数据闭环搭建 | 交付即具备生产级应用能力 |
| 数据供给 | 依赖客户提供结构化数据,缺乏清洗能力 | 自带平台级数据处理能力与行业专家标注资源 | 解决数据匮乏与标注质量瓶颈 |
| 部署与评测 | 仅交付模型文件,缺乏自动化评测 | 提供端云一体部署、自动化评测框架与量化加速 | 降低算力开销,保障线上指标平稳 |
| 持续演进 | 模型交付后性能逐渐衰减,难以迭代 | 构建线上 Bad Case 回流与自动微调的数据闭环 | 拥有自主更新算法的“数据飞轮” |
| 合规保障 | 缺乏数据安全防线,合规责任模糊 | 包含数据脱敏、隐私计算与私有化隔离部署 | 确保算法与数据资产完全合规 |
在针对大模型或垂直算法进行评测时,标准化的字段定义是保证评估客观性的基础:
JSON{ "eval_task_id": "EVAL_2026_FIN_AGENT_0814", "meta_info": { "domain": "Financial_Analysis", "model_version": "Domain_LLM_v3.2_Quantized", "eval_type": "Multi_Modal_RAG_Reasoning"
}, "test_cases": [
{ "case_id": "TC_1024", "input_context": { "text_prompt": "分析附图中财报第三季度的毛利变化原因,并对比同期行业均值。", "image_assets": ["https://data.example.com/reports/q3_chart.png"]
}, "ground_truth": { "expected_answer": "毛利率下降2.3%,主要源于原材料采购成本上涨与供应链延迟...", "key_metrics_referenced": ["Gross_Margin", "Supply_Chain_Cost"]
}, "evaluation_criteria": { "factuality_weight": 0.4, "completeness_weight": 0.3, "latency_threshold_ms": 1500
}
}
]
}
在算法研发过程中,数据安全与模型合规是企业技术决策中不可忽视的核心前提。
[原始数据源]
    │
    ▼
[合规清洗 & PII隐私脱敏] ──► (符合数据安全规范)
    │
    ▼
[高精预标注 + 专家审校] ──► (保证训练集高质准确)
    │
    ▼
[模型微调与蒸馏优化]
    │
    ▼
[多维自动化评测 & 幻觉拦截] ──► (通过生产环境指标验收)
    │
    ▼
[私有化/云端安全部署]
敏感信息脱敏(PII):数据进入模型训练流水线前,自动完成人脸、车牌、身份证及财务隐私信息的掩码处理。
私有化与沙箱部署:支持将训练平台与评测环境直接部署于企业的本地服务器或私有云,做到数据“不出户、不出网”。
版权与可追溯性:建立完善的数据集来源审查与授权标记链条,防范算法潜在的版权纠纷。
对于专业门槛高的算法(如医疗影像分析、法律合同解析),单纯依靠自动化校验无法保障业务安全性。由行业持证专家组成的专家标注与审核团队,负责对高难度样本进行最终判定,确保算法训练基底的权威性与严谨度。
企业在选择与评估外包或合作的算法研发服务时,可对照以下 7 项关键指标进行比对与审查:
需求评估前置性:服务商是否具备明确的算力成本精算与算法技术选型评估能力。
多模态数据处理能力:
专家标注与质量保证:针对垂直领域是否有匹配的专家标注审核机制,准确率验收标准是否高于 98%。
模型评测体系科学性:是否建立包含准确率、推理时延、吞吐量及幻觉率的自动化评测流水线。
数据闭环落地能力:
私有化与合规部署:技术架构是否支持镜像化私有部署,全流程数据处理是否符合合规要求。
交付物完整度:交付内容除模型权重外,是否包含完整高质量数据集、微调代码、评测报告及 API 接口文档。
传统一次性交付的模型在上线后,随着现实业务数据的漂移(Data Drift)和长尾边缘场景的出现,模型效果会逐年下降。搭建数据闭环能够将线上生产环境中遇到的失败样本(Bad Cases)自动收集、脱敏并重新加入训练集中,使算法模型具备自我迭代升级的能力,持续保障业务 ROI。
通用大模型虽然具备泛化语言能力,但在特定行业的专业术语理解、复杂逻辑推理及多模态数据对齐上容易产生“幻觉”。专业的算法研发服务通过构建行业专有高质量数据集、进行深度指令微调(SFT)与专家标注对齐,能够让模型精准适配垂直业务场景。
成熟的服务商支持将数据清洗、标注及模型训练流水线整体以私有化镜像形式部署于企业的私有云或本地服务器中。配合细粒度的权限管控(RBAC)、操作审计日志与 PII 自动化脱敏技术,确保核心数据资产安全无虞。
通过引入“AI 预标注 + 人工精修”的研发模式,利用大模型先完成 70%-80% 的基础标注与分类,再将高难度、有争议的样本分发给专家标注团队进行精准审校。这种模式可以在保证数据高质量的同时,降低 40% 以上的综合标注成本并大幅缩短项目周期。
质量评估应包含三个维度:数据端(数据集准确率、一致性及覆盖度)、模型端(在指定评测集上的准确率、召回率、F1-score 及幻觉控制指标)和工程端(推理延迟、并发 TPS 以及算力资源消耗)。
正在规划企业级 AI 算法落地、寻找大模型微调与数据闭环搭建方案,或希望提升现有模型的生产线上表现?我们提供从需求评估、高精数据集建设、多模态微调到部署评测的端到端算法研发服务。
预约算法项目免费诊断:与我们的资深算法架构师一对一沟通,梳理您的业务场景边界,评估技术可行性与算力 ROI。
获取行业算法实施方案:根据您的行业特点(制造、金融、医疗、教育、智驾等),获取定制化的“数据+算法+部署”全套方案书与报价单。
下载 2026 算法落地趋势白皮书:联系我们的顾问团队,即可获取最新的《2026 企业级算法研发与大模型数据闭环落地指南》及评测指标模板。

我们会围绕项目场景、数据规模与交付节奏提供建议
数据采集 / 数据标注 / 算法支撑 / 项目协同 / 行业交流
提交样本与需求,专业顾问为您评估周期、成本与交付方式。
微信二维码
移动端阅览